GPT-6 モデルと推論設定の選び方
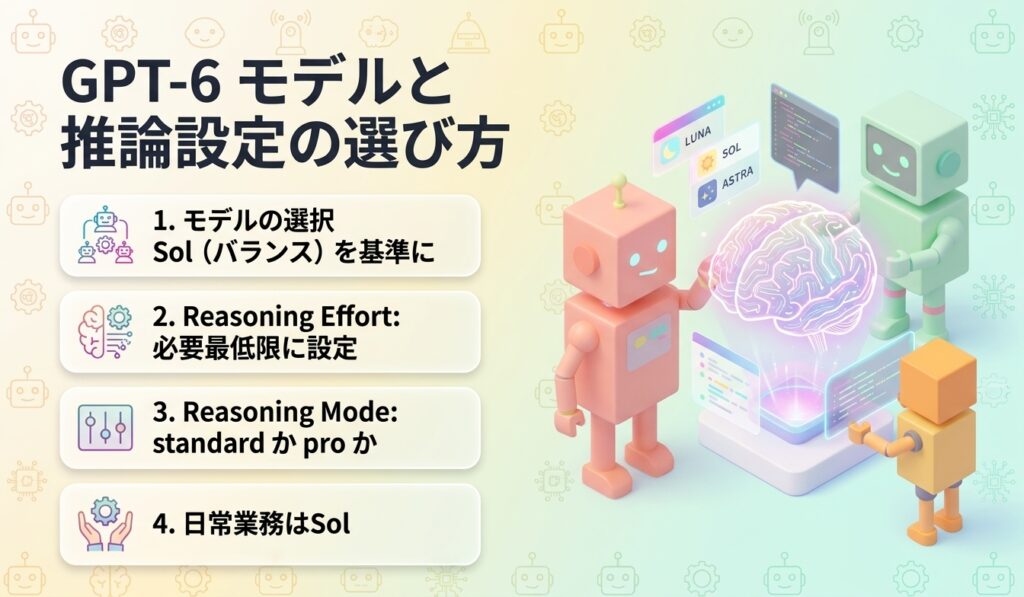
ChatGPTやAPIでGPT-6を使うとき、AstraやSol、Lunaといったモデル名に加えて「推論設定」も選ぶ必要があります。どれを選べばよいか迷いやすいところです。押さえるべきは3つの軸で、順番に決めれば絞り込めます。実務での目安はSolのmediumを基準の候補にすること。作業別の組み合わせを表で整理します。
【出典元】Introducing GPT-6 Sol and Luna(OpenAI)
選ぶ順番は3ステップ
設定項目が多く見えますが、決める順番は決まっています。
- モデルを選ぶ(Luna/Sol/Astra)
- reasoning effortを選ぶ(noneからmaxまで)
- reasoning modeを選ぶ(standardかpro)
基本方針はシンプルです。能力とコストのバランスを取りたい日常業務ではSolを基準にしやすく、最高品質を優先する場合はAstra、単価や大量処理を重視するならLunaを検討します。reasoning effortは必要以上に上げず、代表的な業務で比較評価して決めるのが現実的です。
まずモデルを選ぶ
3つのモデルは、役割がはっきり分かれています。
| モデル | 位置づけ | 向いている仕事 | 選ぶ目安 |
|---|---|---|---|
| Luna | 最も効率重視 | 分類・抽出・整形・大量処理・繰り返し作業 | 答え方が決まっていて、1件あたりのコストや速度が重要 |
| Sol | 能力とコストのバランス | 調査、資料作成、分析、コーディング、業務フロー | 能力とコストのバランスを取りたい業務の候補 |
| Astra | 最高能力 | 難しい推論、研究、複雑な開発、コンピューター操作、重要な判断 | 品質優先・失敗コストが高い・難度が高い |
次にreasoning effortを選ぶ
AIにどれだけ考えさせるかの設定です。対応するモデルが設定ごとに違う点に注意してください。
| 設定 | 対応モデル | 主な用途 | 使い方の目安 |
|---|---|---|---|
| none | Sol/Luna | 分類、抽出、定型変換、単純な問い合わせ処理 | 推論がほぼ不要。最速・最省トークン寄り |
| low | Astra/Sol/Luna | データ分析、下書き、定型コード、カスタマーサポート | 明確な指示があり、判断が限定的 |
| medium | Astra/Sol/Luna | 調査、表計算、スライド、エージェント型コーディング | 複数ステップを伴う通常の知的業務 |
| high | Astra/Sol/Luna | 難しい推論、複雑なデバッグ、長めの調査・ワークフロー | 精度を優先したい難題 |
| xhigh | Astra/Sol/Luna | 深いレビュー、セキュリティ、長時間のエージェント処理 | 失敗コストが高い複雑タスク |
| max | Astra/Sol/Luna | 最も複雑で品質優先の仕事 | 本当に改善するか評価したうえで限定利用 |
注意点が2つあります。GPT-6各モデルの対応一覧にminimalは含まれません。既存設定でminimalを使っている場合、またはnoneからAstraへ移行する場合は、lowから比較評価するのが公式ガイドです。またAstraはnoneに非対応で、noneが使えるのはSolとLunaだけです。
3つ目の軸はreasoning mode
見落とされがちなのが、effortとは別に選べるreasoning modeです。Responses APIでstandardとproのどちらかを指定します。
既定はstandardです。proは難しい品質優先タスクで、より多くのモデル処理を行うため、待ち時間とトークン使用量が増えます。effortとmodeは独立しているので、最難関のタスクでは同じeffortのままstandardとproを比較評価するという進め方になります。
作業別のおすすめ組み合わせ
ここからが実務の話です。以下はOpenAIの公式ガイドをもとにしたマッピング例で、公式が作業ごとに固定の設定を指定しているわけではありません。実際の設定は、品質・待ち時間・トークンコストを比較して決めます。
| 具体的な作業 | モデル | 設定 | 選ぶ理由 |
|---|---|---|---|
| 問い合わせメールを種類別に仕分ける | Luna | none-low | 答え方が決まっており、深い推論が不要 |
| アンケート自由記述を分類・集計 | Luna | low | 大量処理で1件あたりの効率が重要 |
| 議事録を要約して箇条書き化 | Luna | low | 元情報があり、判断が少ない |
| 商品説明文を指定形式に整える | Luna | none-low | 変換・整形中心の作業 |
| 顧客対応の一次返信を下書き | Sol | low | 一定の判断と文章品質を両立 |
| 売上データを分析してグラフ化 | Sol | low-medium | 分析中心。複雑ならmediumへ |
| 記事・提案書の下書き | Sol | low-medium | 明確な材料があればlow、構成検討はmedium |
| 既存コードのバグ修正 | Sol | low-medium | 範囲が明確ならlow、原因探索を伴えばmedium |
| 表計算やスライドを作らせる | Sol | medium | 複数工程・構成判断が必要 |
| 複数手順の調査とレポート作成 | Sol | medium-high | 通常はmedium、調査が深ければhigh |
| 新機能をゼロから実装 | Sol | medium-high | エージェント型コーディング。難度で調整 |
| 長時間・多数ツールを使う自動処理 | Sol | high-xhigh | 長期ワークフローは高めのeffortが有効 |
| 複雑なバグの原因究明 | Astra | high | complex debuggingに該当する難題 |
実務での使い分け
運用の指針を4点にまとめます。
- 日常の知的業務ではSol/mediumを基準設定の候補にすると運用しやすい
- 単純・大量・反復作業はLuna/none-lowに下げ、コストと速度を最適化する
- 難しい推論、複雑なデバッグ、重要な研究やレビューはAstra/high以上を検討する
- 高いeffortやpro modeが常に正解ではない。代表的な業務で成功率・待ち時間・トークンコストを比較して決める
参考になる実測値
設定の効きを示す数字として、OpenAIの公表値があります。業務ワークフローを測るAutomationBenchで、GPT-6 Sol(xhigh)がClaude Opus 5(max)を上回り、1タスクあたりのコストはOpus 5の約9%でした。
ただしこれは特定のベンチマークの結果です。すべての業務にそのまま当てはまる数字ではありません。自社の代表的な作業で試して確かめるのが確実です。
まとめ
GPT-6の設定は、モデル・reasoning effort・reasoning modeの3段階で決めます。迷ったらSol/mediumから始め、単純作業はLunaへ落とし、難題だけAstraへ上げてください。minimalは対応一覧にないため、使っている場合はlowから比較評価するのが公式の指針です。設定を上げるほど良くなるとは限らないので、代表的な業務で実際に測って判断することをおすすめします。