Opus 5.5が4割安くなった
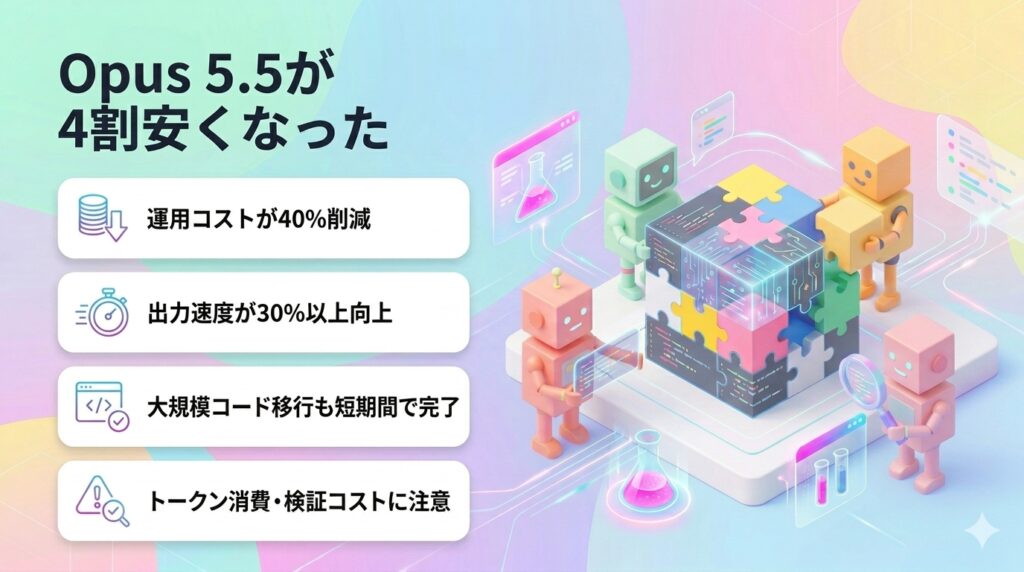
性能を上げながら値下げする。Anthropicは2026年9月22日、Claude Opus 5.5を公開しました。多くの作業で上位モデルFable 5.1と並ぶ性能を出しつつ、運用コストはOpus 5比で40%減です。早期のテスターからは「68万行のコード移行が1日で終わった」という報告も出ています。ただし実際に検証した第三者からは、手放しで喜べない指摘も上がっています。
【出典元】Introducing Claude Opus 5.5(Anthropic)
キャッシュ読み取りは6割減
値下げの中身を見ると、実務への効きどころがはっきりします。100万トークンあたりの料金です。
| 項目 | Opus 5.5 | Opus 5からの変化 |
|---|---|---|
| 入力 | $4 | 20%減 |
| 出力 | $20 | 20%減 |
| キャッシュ読み取り | $0.20 | 60%減 |
とくに効くのがキャッシュ読み取りです。エージェント型の作業やコーディングでは、費用の大半がここに集中します。そこが6割下がったことで、典型的な使い方では全体で40%安くなる計算です。出力速度も30%以上向上しました。あわせてPro・Max・Team・Enterpriseの5時間あたりの上限が引き上げられ、好きなときに使えるリセット権も配られています。
68万行の移行を1日で完了
公式が挙げた早期テスターの成果は、具体的です。
- ある利用者は68万行のコード移行を1日以内で完了。従来ならエンジニアチームで数週間かかる作業
- Webアプリ全ページの読み込み時間短縮を依頼したところ、40回中39回成功。Opus 5は改善幅が小さく、しかもアプリの挙動を変えてしまった
- 1つの指示からゲームを作らせる比較では、グラフィックと完成度で最高評価
文章面の改善も報告されています。要点を先に置く書き方になり、専門用語も減りました。あるテスターは「自分と同じように書く」と評しています。
数字の差は当てにならない
ベンチマークでは軒並み高い数値が出ています。ターミナル操作のTerminal-Bench 4.0で66.4%を記録し、Fable 5.1の55.8%、GPT-6 Astraの57.9%を上回りました。
興味深いのは、Anthropic自身の注記です。同社は「この能力水準では、ベンチマークの差が現実の違いを測る目安として当てにならなくなった」と述べ、自社で使った実感ではFable 5.1との差はスコアほど大きくない、と正直に書いています。数字だけで選ばないでほしい、というメッセージにも読めます。
トークン消費は5割増の指摘
第三者の検証では、別の面も見えてきました。コードレビュー支援のCodeRabbitが実際に試した結果です。
良い点は明確でした。バグ検出で80件中51件(63.8%)を捕らえ、従来モデルの49件(61.3%)を上回っています。難易度の高い13件では、最大設定で10件(76.9%)を検出しました。従来は5件(38.5%)だったので、大きな差です。複数の処理がぶつかる競合状態など、従来が見落としていた種類のバグも指摘できました。
一方で、気になる数字もあります。
- トークン消費が標準設定で49.2%増、最大設定で57.6%増
- レポートのコメント数が116件から127〜140件に増加し、人が確認する作業は増えた
- 従来モデルが見つけた9件のバグを見落とす例もあった
単価が下がっても消費量が増えれば、支払いは思ったほど減りません。自分の使い方で実際に安くなるかは、試して確かめる必要があります。
減速を訴えた後の初リリース
このモデルには、もう一つの意味があります。AnthropicのCEOが「AI開発のペースを保とう」と呼びかけて以降、同社が初めて出したモデルだという点です。
公開前には外部の評価者であるFrontier DesignとMETRが検証しました。同社が実施する最も包括的なアラインメント検査(自動行動監査)では、これまでで最良の結果を記録しています。取り返しのつかない行動を取りにくく、与えられた範囲の外へ出にくい。悪意ある指示文への耐性も向上しました。言葉だけで終わらせなかった形です。
まとめ
Opus 5.5は、性能を上げて値段を下げた実利の大きい更新です。とくにキャッシュ読み取りの6割減は、エージェント作業を日常的に回す人に効きます。ただしトークン消費が増えるとの検証もあり、実際の請求額は使い方次第です。Claudeを業務で使っている方は、まず数日試して費用の増減を見てから、本格的に切り替えるか判断するのが堅実です。SonnetとHaikuの5.5も数週間内に登場予定です。